
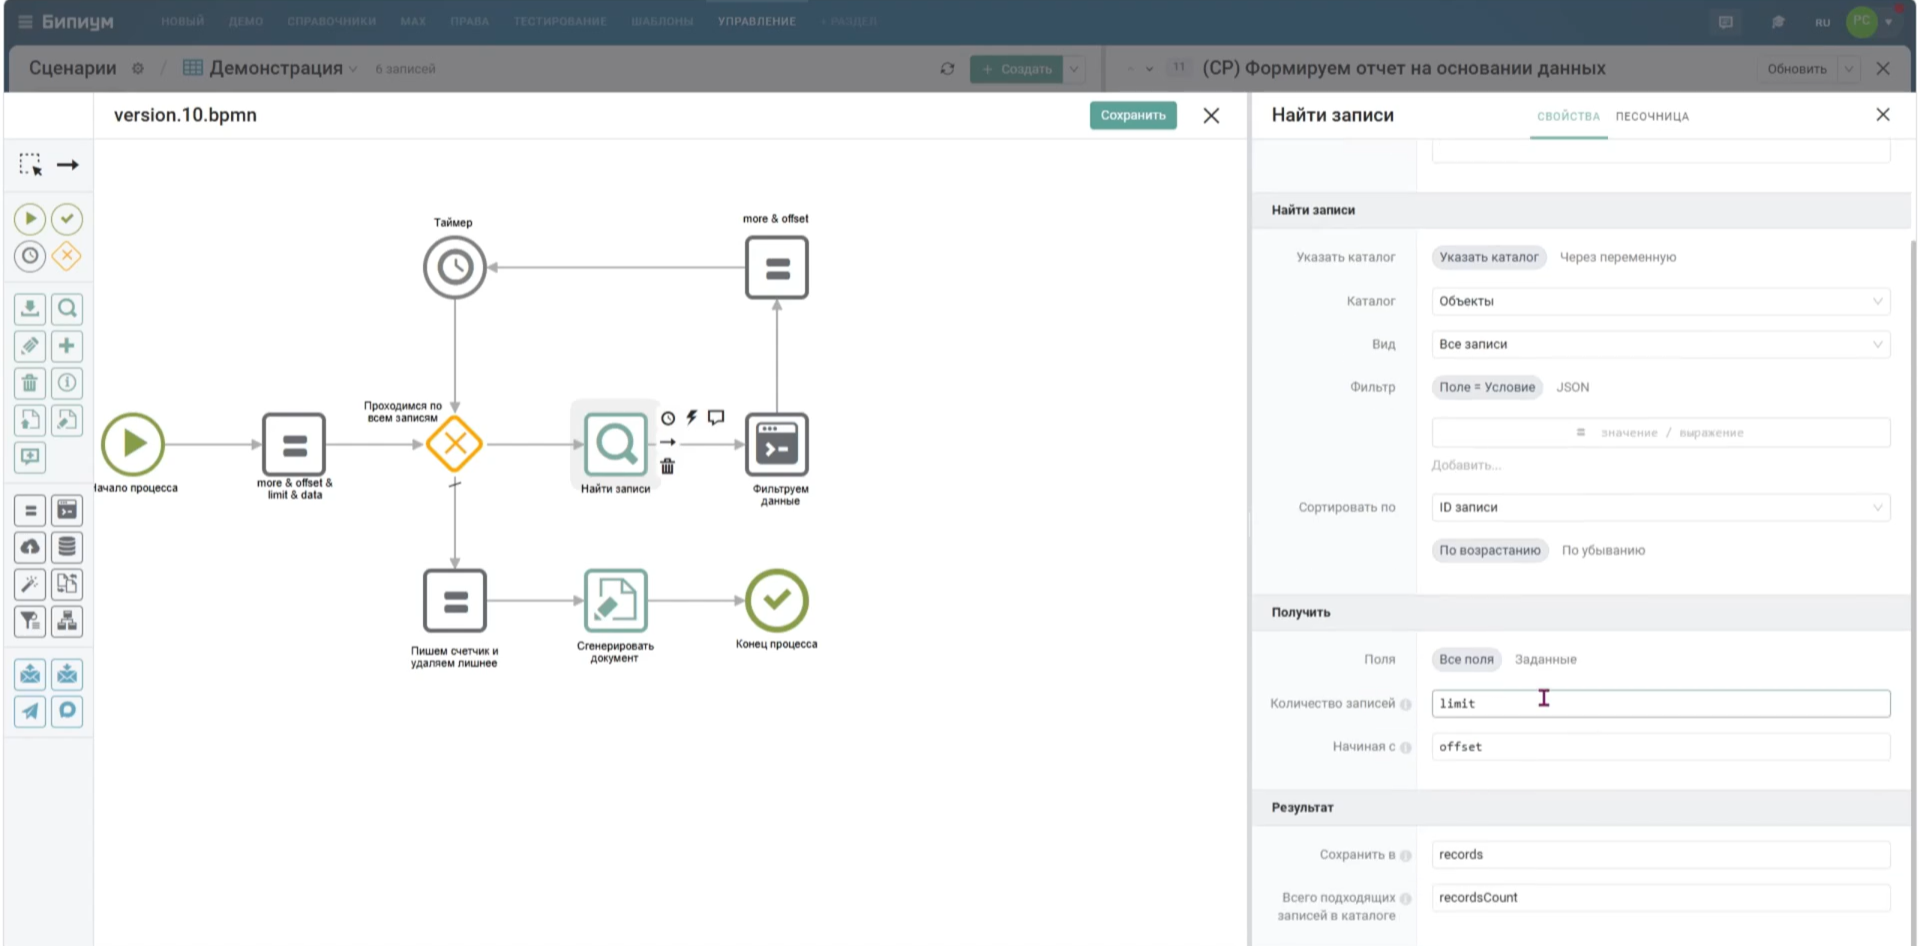
При небольшом количестве записей сценарий может обрабатывать данные одним массивом. Но когда каталог содержит тысячи записей, такой подход становится менее подходящим: увеличивается объем данных, который одновременно проходит через сценарий, а при дальнейшей фильтрации и обработке нагрузка возрастает.
В Бипиуме для таких задач можно построить сценарий, который получает записи небольшими наборами и последовательно проходит весь каталог. В этой инструкции разберем конструкцию на примере каталога «Объекты»: записи будут загружаться по 1000 штук, фильтроваться, добавляться в общий массив, а после завершения цикла использоваться для формирования отчета.
Определите размер набора данных
Первый шаг — определить, сколько записей сценарий будет получать за одну итерацию. В демонстрации используется значение 1000. Для этого создается переменная limit. Она хранит размер одной выборки и затем передается в компонент «Найти записи».
Вторая переменная — offset. Она определяет, с какой позиции начинать следующую выборку. В начале сценария ее значение равно 0.
Третья переменная — more. Она отвечает за продолжение цикла. В начале ей задается значение true, чтобы сценарий мог перейти к первой итерации.
Наконец, создается пустой массив data. Он будет использоваться для накопления результатов всех итераций.
Получайте записи по limit штук
После начальной настройки сценарий переходит к шлюзу, который проверяет значение more. Пока оно равно true, сценарий входит в цикл. Внутри цикла используется компонент «Найти записи». В нем указывается каталог «Объекты», количество записей — переменная limit, а начало выборки — offset. При первом запуске получается первая тысяча записей. Затем после завершения обработки offset увеличивается на 1000, и следующий запрос начинается уже с новой позиции. За счет этого сценарий не обращается ко всему каталогу одновременно.
Обрабатывайте текущий набор записей
Полученный массив сохраняется в переменную records. Далее он передается в компонент кода вместе с накопленным массивом data. На этом этапе можно выполнять необходимую обработку. В демонстрации используется фильтрация объектов: из текущей тысячи записей выбираются те, которые еще не имеют статуса «сдан» и стоимость которых меньше полутора миллиардов. Каждая запись, соответствующая условиям, добавляется в data.
Здесь records и data выполняют разные функции. Первый массив содержит только текущий набор, второй постепенно накапливает итоговый результат.
Добавляйте результаты каждой итерации в общий массив
На первой итерации data пустой. После фильтрации в него попадают подходящие записи из первой тысячи. На следующей итерации в сценарий снова передается data, но теперь в нем уже есть результат предыдущего прохода. К нему добавляются записи из нового набора. Так продолжается до окончания каталога. В результате после последней итерации data содержит все записи, которые прошли заданную фильтрацию.
Проверяйте окончание цикла
После обработки очередного набора необходимо определить, есть ли еще записи. Для этого количество элементов в records сравнивается со значением limit. Если сценарий получил ровно 1000 записей, more остается true: предполагается, что существует следующая порция. Если записей меньше 1000, значит, сценарий дошел до конца каталога и more становится false.
Например, при 3200 записях будут обработаны три полных набора по 1000 и последний набор из 200 записей. Именно размер последней выборки позволит сценарию завершить цикл.
Добавьте небольшую паузу между итерациями
В демонстрационном сценарии между проходами используется компонент таймера с паузой 0,1 секунды. Такая пауза используется для более стабильной работы циклической обработки. Сам принцип при этом не меняется: сценарий получает очередной набор, обрабатывает его, обновляет offset и переходит дальше. После выхода из цикла временная переменная records больше не нужна. Ее можно обнулить, поскольку весь требуемый результат уже находится в data.
Передайте накопленные данные в отчет
Когда все записи обработаны, массив data можно использовать в следующем компоненте. В демонстрации применяется компонент «Сгенерировать документ». Для него заранее создается шаблон с полями наименования компании, стоимости проекта, планируемой даты завершения и комментариев. Отдельная переменная count содержит количество записей в итоговом массиве. При передаче переменной внутрь строки используется конструкция с обратными кавычками и ${}. В результате в шаблон передаются data и count, после чего формируется готовый отчет.
Запускайте обработку через внешний запрос
Для запуска такого сценария в демонстрации используется внешний запрос. В его записи задаются URL-идентификатор и сценарий, который необходимо выполнить. После настройки сценарий можно вызвать по адресу: [Домен]/api/webrequest/[URL-идентификатор]
Это позволяет запускать обработку отдельно и контролировать ее выполнение. В демонстрации после запуска результат появляется в соответствующем поле записи.
Что получилось в демонстрации
Исходный каталог содержал 3000 записей. После прохождения всех наборов и применения фильтра в итоговый массив попало 1379 объектов. При этом сам отчет — только пример конечного действия. После цикла можно выполнять и другую обработку: изменять данные, передавать их дальше или использовать в другом сценарии. Основная конструкция остается неизменной: limit задает размер набора, offset перемещает сценарий к следующей порции, more определяет необходимость продолжения, а data хранит накопленный результат.
Демонстрация настройки: "Обработка больших объемов данных"

